

Betriebsfähigkeit entscheidet, ob eine Plattform wirklich genutzt werden kann.
Self-Service taucht in Plattform-Roadmaps oft überraschend früh auf: ein neues Team soll in der Lage sein, eine Umgebung innerhalb weniger Minuten bereitzustellen, Datenbanken sollten mit einem Klick angelegt werden können, neue Dienste sollten nach Möglichkeit ohne Ticket genutzt werden können.
Das sind vernünftige Ziele. Bei einer Plattform, auf der kritische Workloads gehostet werden, muss jedoch zunächst eine andere Frage im Vordergrund stehen: Was passiert, wenn etwas schiefgeht?
Kann das Team sehen, was gerade passiert? Kann es einen Dienst wiederherstellen? Ist der Zugriff nachvollziehbar? Können Sicherheitsupdates kontrolliert über die Plattform bereitgestellt werden? Und ist klar, wer bei einem Vorfall welche Entscheidung trifft?
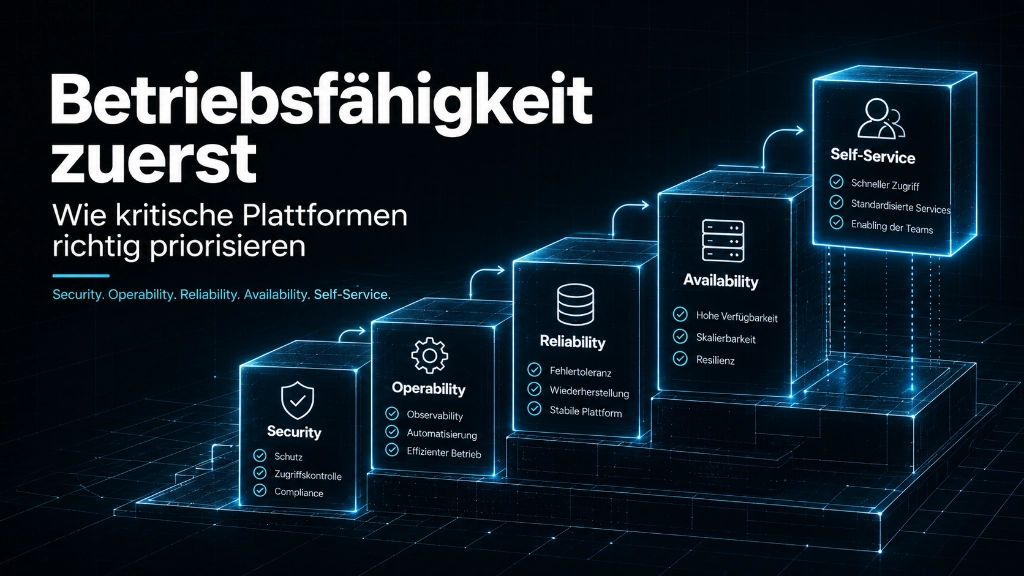
In einem aktuellen Private-Cloud-Mandat für kritische Infrastruktur hat sich daraus eine einfache Priorisierungslogik entwickelt:
Security → Operability → Reliability → Availability → Self-Service
Dies ist kein universelles Rahmenwerk für jede Plattform, sondern beschreibt eine wichtige Produktlogik für Umgebungen, in denen operationelle Risiken Wert schneller zerstören können, als durch zusätzliche Self-Service-Features Wert geschaffen werden kann.
Jede Stufe verändert die nächste Produktentscheidung
Security beginnt bei Identitäten, Berechtigungen, Isolation und nachvollziehbaren Zugriffen. Das Produktteam muss wissen, wer oder was handelt und welche Grenzen gelten.
Operability beantwortet die Frage, ob ein Team das System im Alltag tatsächlich betreiben kann. Observability, Runbooks, kontrollierte Deployments und klare Ownership sind hier Produktbestandteile.
Reliability macht aus funktionierender Software ein verlässliches System. Fehlerfälle, Wiederholbarkeit, Recovery und definierte Betriebsgrenzen werden explizit.
Availability wird erst glaubwürdig, wenn diese Grundlagen unter realen Bedingungen tragen. Dazu gehören Backup und Restore ebenso wie Disaster-Recovery-Szenarien und getestete Betriebsabläufe.
Self-Service kann darauf aufbauen. Dann automatisiert er einen belastbaren Weg, statt einen unreifen Prozess lediglich schneller verfügbar zu machen.
Ein Update ist ein guter Messpunkt für die Betriebsbereitschaft
Ein wichtiger Indikator für die Reife einer Plattform ist ein sicherheitskritisches Update. Nehmen wir zum Beispiel ein notwendiges CVE-Fix-Update. Der gesamte Prozess umfasst mehrere Schritte: Image-Erstellung, Paketierung, Integration in den Plattform-Stack, Bereitstellung, Integrationstests, Abnahme und kontrollierte Auslieferung.
In unserem aktuellen Mandat hat sich dieser Prozess im Laufe des Projekts erheblich verändert. In der frühen Greenfield- und Factory-Einrichtungsphase konnten umfangreiche Releases Monate dauern – die Plattform war noch weit davon entfernt, produktionsreif zu sein. Heute lassen sich vergleichbare sicherheitsrelevante Änderungen innerhalb eines viel kürzeren, vorhersehbaren Lieferfensters durch die Plattform führen. Eine wichtige Erkenntnis: Es kommt nicht nur auf das Schiff an, das man baut, sondern auch auf die Schiffswerft, mit der man das Schiff baut. Oder, um es ohne Analogie auszudrücken: Eine Plattform ist nur dann wirklich betriebsbereit, wenn Plattform-Teams schnell genug auf Änderungen reagieren können – alles andere ist nur eine Momentaufnahme.
Für uns ist dies ein interessanterer Reifegradindikator als die Anzahl der Self-Service-Angebote, denn er zeigt, ob Produkt, Technologie und Betrieb als System funktionieren.
Woran Ihr zu frühes Self-Service erkennt
Ein Plattformteam sollte hellhörig werden, wenn Provisioning immer einfacher wird, während im Hintergrund manuelle Betriebsarbeit wächst.
Weitere Warnsignale sind viele Ausnahmen pro konsumierendem Team, fehlende Recovery-Tests, unklare Ownership im Incident oder ein Release-Prozess, der nur mit einzelnen Schlüsselpersonen funktioniert.
In solchen Situationen ist ein weiterer Ausbau des Self-Service noch nicht sinnvoll, da er zunächst die Anzahl der Nutzer erhöht und damit den Druck auf ein Betriebsmodell steigert, das noch nicht robust genug ist.
Was wir stattdessen messen würden
Die Akzeptanz von Self-Service ist natürlich nach wie vor relevant. Sie sollte jedoch nicht die einzige Kennzahl für ein Platform-Engineering-Projekt sein. Bei einer Plattform, die kurz vor oder kurz nach der allgemeinen Verfügbarkeit steht, würden wir auch folgende Indikatoren berücksichtigen:
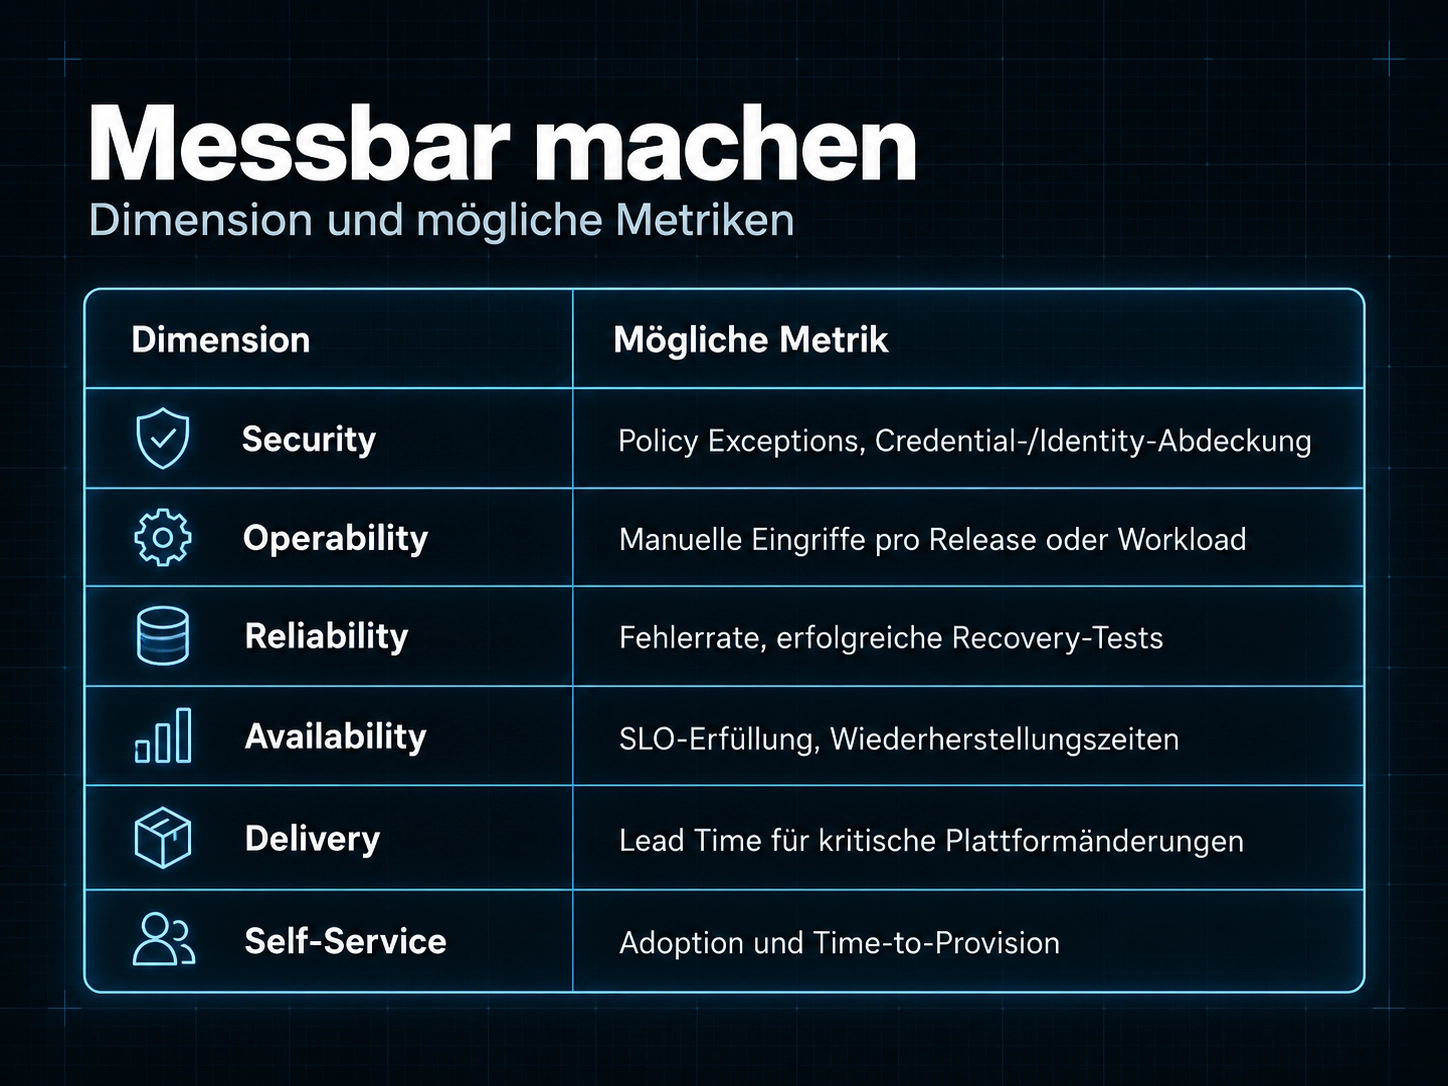
- Sicherheit: Policy Exceptions, Credential-/Identity-Abdeckung
- Betriebsfähigkeit: manuelle Eingriffe pro Release oder Workload
- Zuverlässigkeit: Fehlerquote, erfolgreiche Wiederherstellungstests
- Verfügbarkeit: Einhaltung der SLOs, Wiederherstellungszeiten
- Bereitstellung: Vorlaufzeit für kritische Plattformänderungen
- Self-Service: Adoption und Time-to-Provision
Welche Werte gut sind, hängt vom Produkt und vom Risikoprofil ab. Entscheidend ist zunächst, dass das Team diese Ebenen überhaupt gemeinsam betrachtet.


